Project Portfolio
서버를 직접 빌려 운영했고, 팀 프로젝트에서 배포와 모니터링을 맡았습니다
Project 01
AI 영화 큐레이션 플랫폼
사용자가 챗봇에게 말을 걸면 AI 큐레이터가 영화를 추천하고 3D 전시회로 만들어 주는 팀 프로젝트.
AI 서빙 서버 구축, GPU 배포, 모니터링, CI/CD 파이프라인을 담당했습니다.
2025.11 ~ 2026.02
AI 서빙, GPU 배포, 모니터링, CI/CD
FastAPI, PyTorch, Docker, Nginx, Prometheus, Grafana, GitHub Actions
VM1에 배정된 저장 용량은 10GB. Frontend, Backend, Nginx, Redis 컨테이너만으로도 저장 공간이 부족한 상황이었습니다.
VM2(GPU 서버)에는 100GB가 배정돼 있었고, AI 모델은 메모리에 올라가니 디스크는 넉넉했습니다. PostgreSQL을 GPU 서버에 설치하고, 접속은 VM1에서만 되도록 네트워크를 막았습니다.
DB로 들어오는 길은 VM1 하나뿐입니다. 스토리지를 따로 늘리지 않고 GPU 서버의 남는 디스크로 해결했습니다.
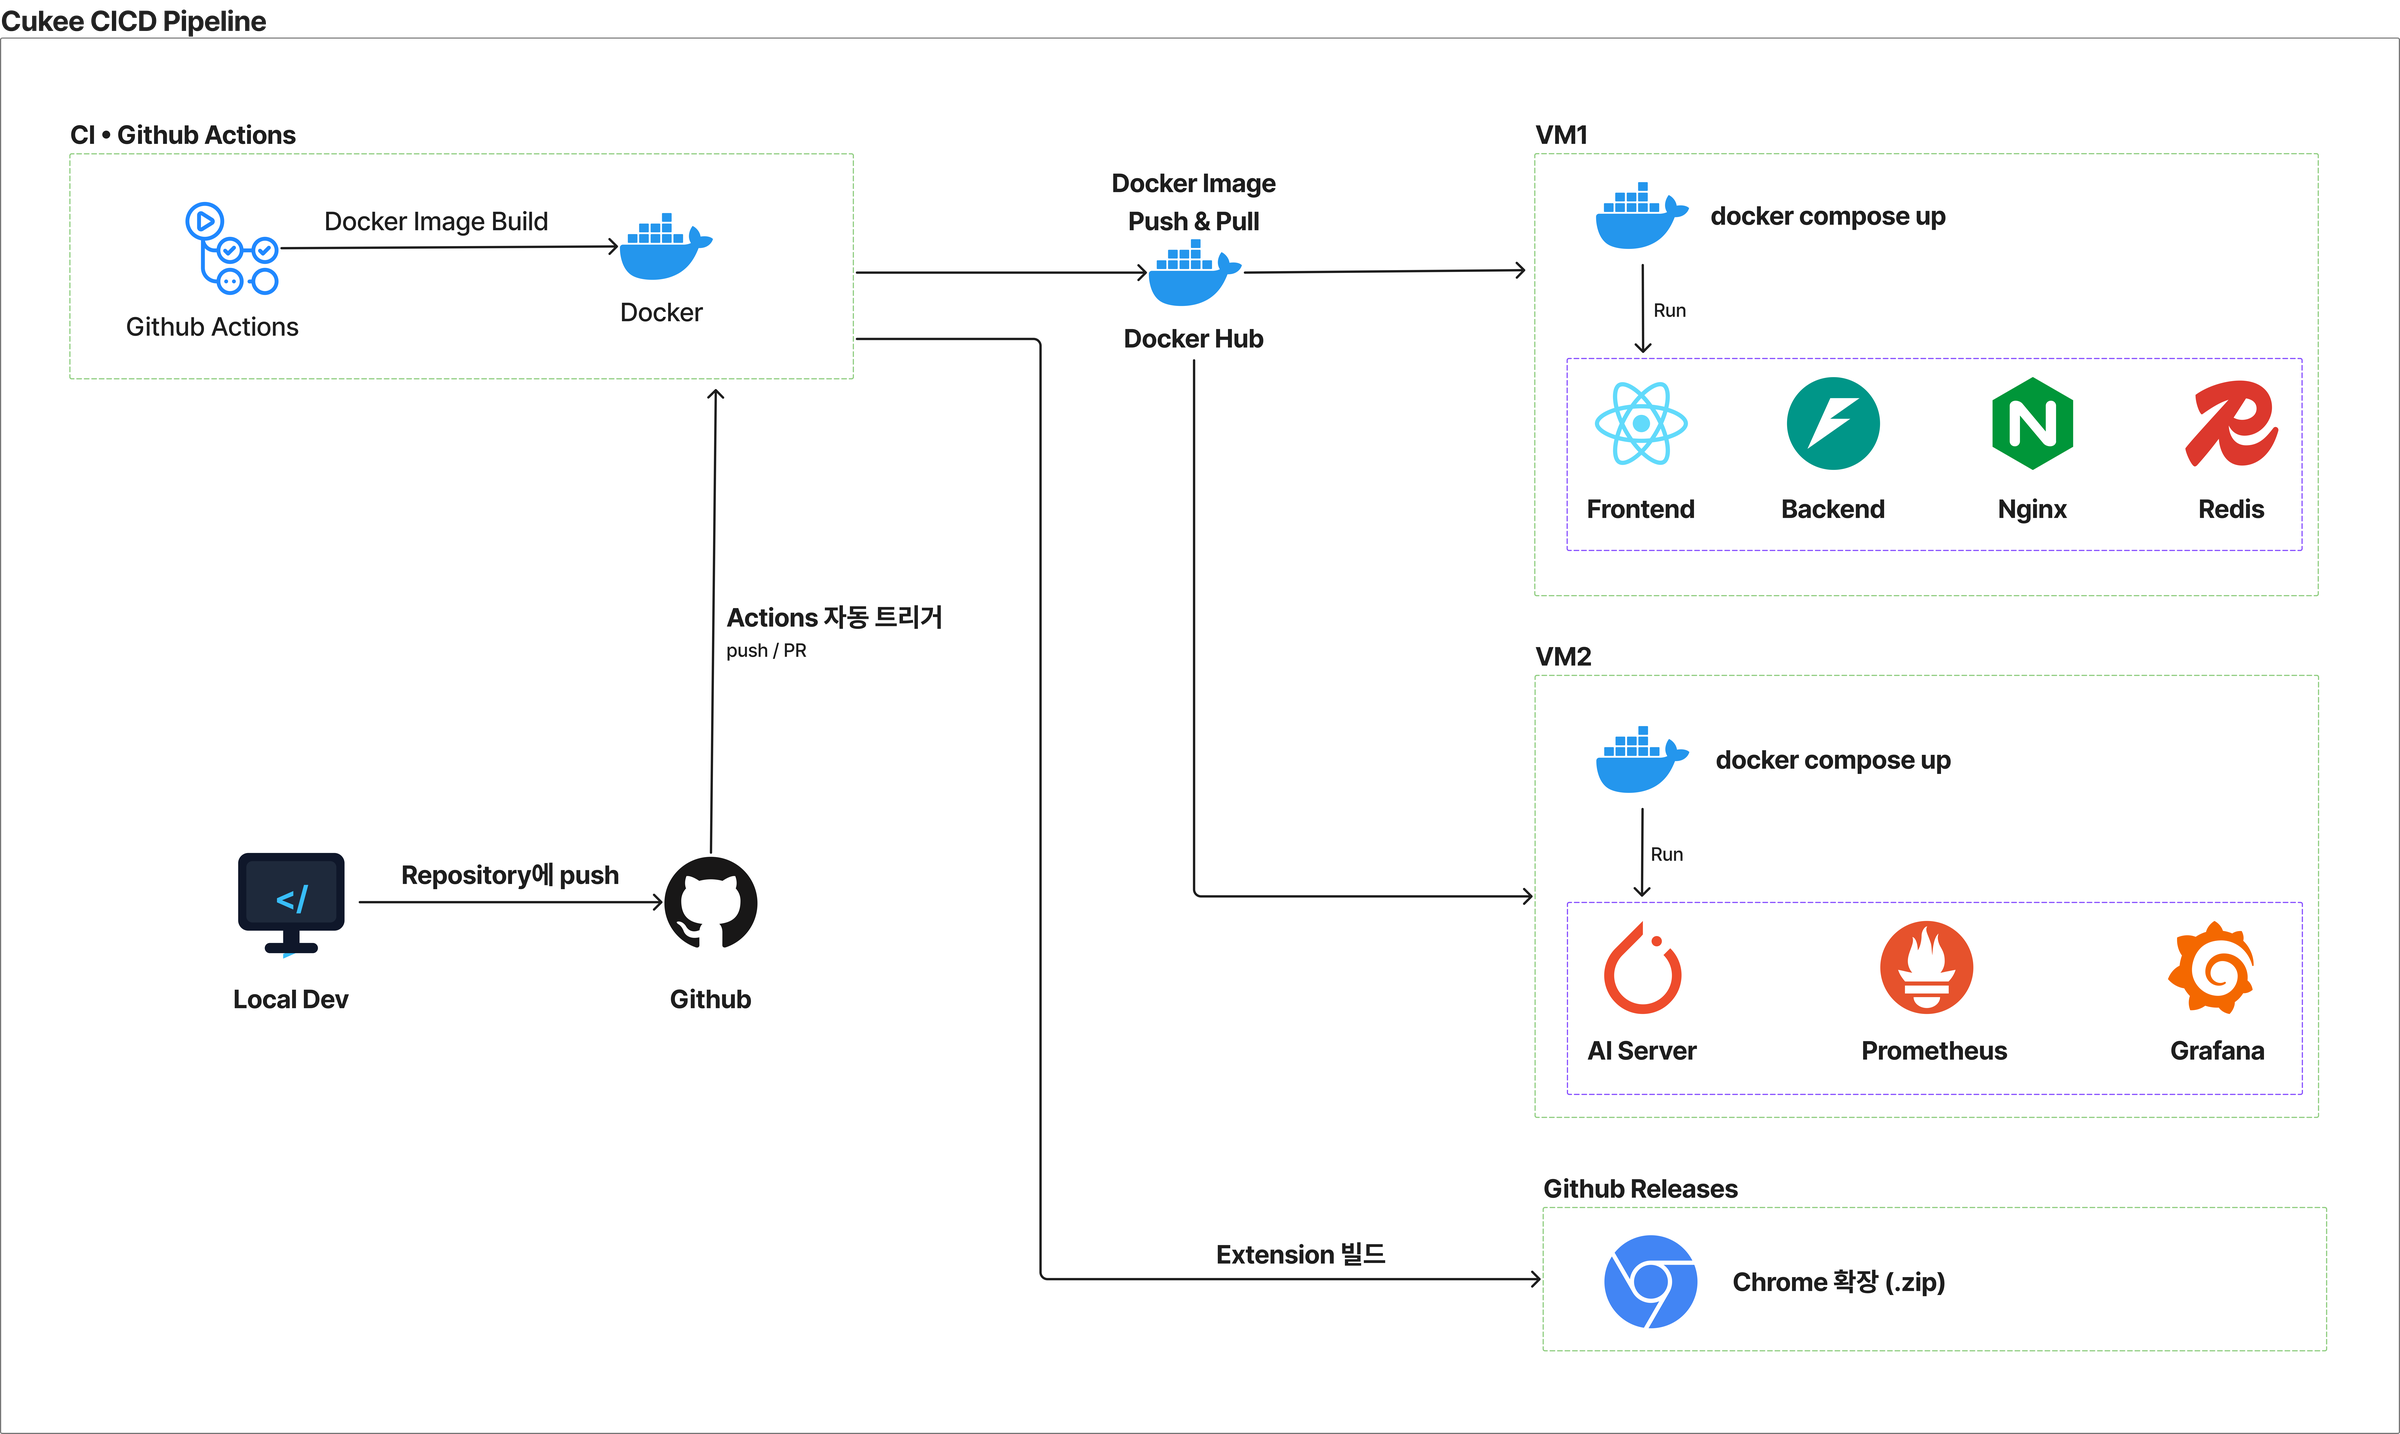
GitHub Actions 워크플로우를 서비스별로 6개로 나눴습니다. 바뀐 서비스만 빌드돼 Docker Hub를 거쳐 VM1(앱 서버)·VM2(GPU 서버)로 나갑니다.
BGE-M3는 PyTorch 2.6.0이 필요했는데, 쓰던 Docker 이미지는 그보다 낮은 버전이었습니다. 모델을 불러오는 순간 런타임 에러가 났습니다.
Dockerfile의 베이스 이미지를 pytorch/pytorch:2.6.0-cuda12.4-cudnn9-runtime으로 바꿨습니다. 바꾸기 전에 T4가 CUDA 12.4를 지원하는지부터 확인했습니다.
그러자 이번엔 bitsandbytes(4-bit 양자화 라이브러리) 빌드가 깨졌습니다. 이미지에 C 컴파일러가 없어서였고, build-essential과 triton을 같이 설치해 해결했습니다.
T4 GPU의 VRAM은 16GB. Qwen-14B는 fp16이면 파라미터 14B × 2바이트로 가중치만 약 28GB라 그대로 올릴 수 없고, 같은 카드에 BGE-M3 임베딩 모델도 함께 올려야 했습니다.
bitsandbytes 4-bit 양자화로 가중치를 fp16의 4분의 1 수준으로 줄여, 임베딩 모델과 추론 중 늘어나는 메모리를 둘 여유를 만들었습니다. VRAM은 로드 직후와 추론 중을 나눠 확인했습니다.
pytorch/pytorch:2.6.0-cuda12.4-cudnn9-runtime에 build-essential과 triton을 더해 양자화 라이브러리가 빌드되게 함
Qwen-14B (4-bit 양자화) + BGE-M3 임베딩. 페르소나는 테마별 시스템 프롬프트로 구현. T4 16GB 한 장에서 운영
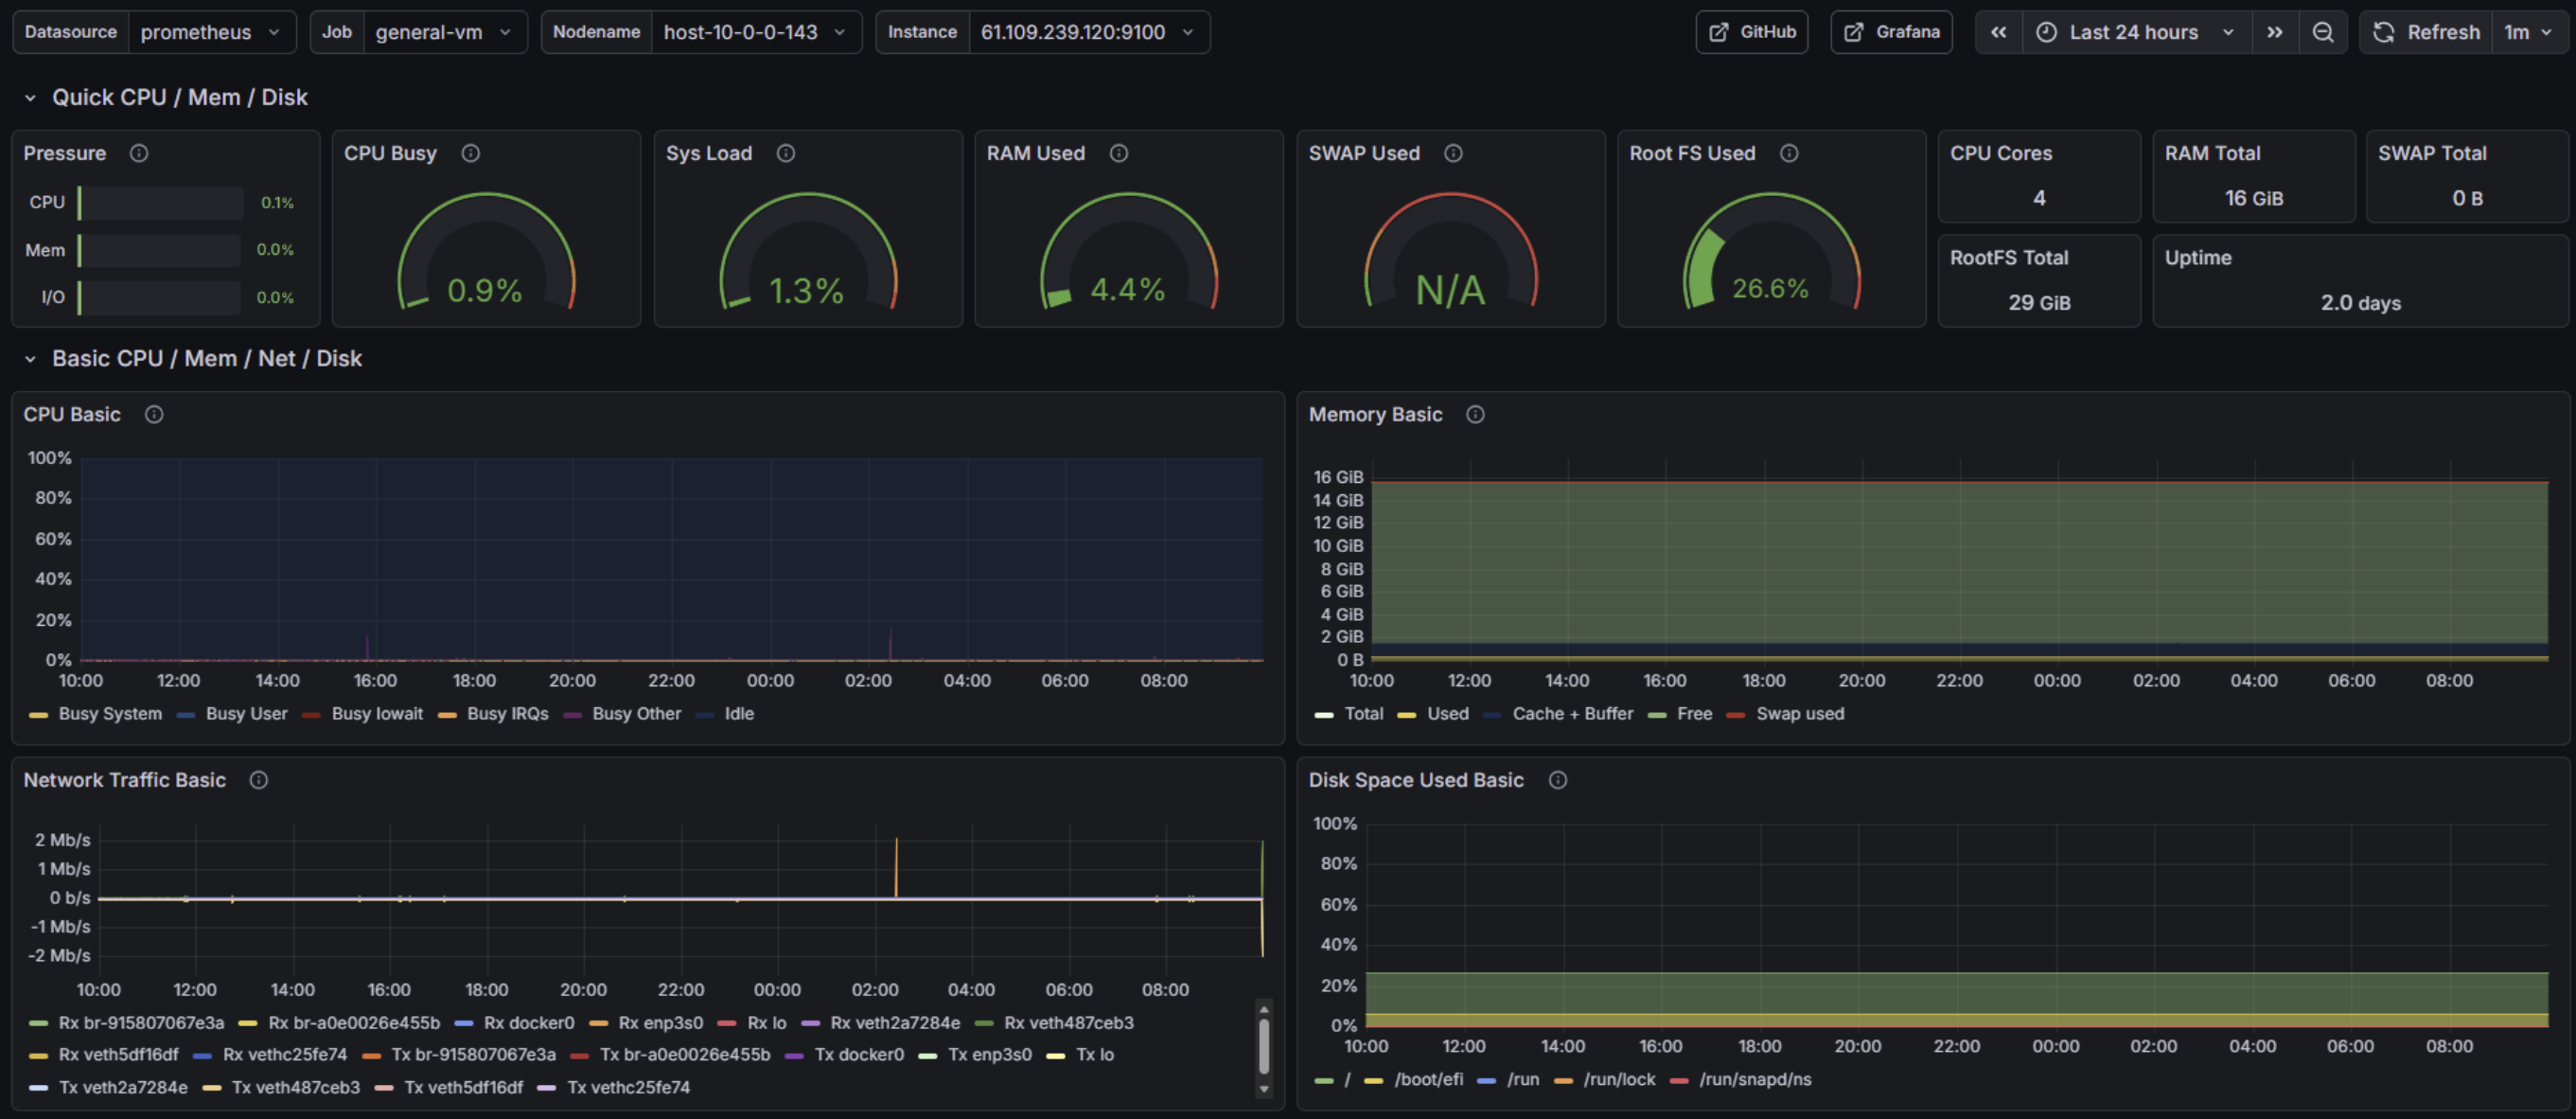
GPU 서버 상태를 계속 볼 수 있게 docker-compose.ai.yml에 모니터링 스택을 같이 넣었습니다.
NVIDIA GPU 메트릭 수집. VRAM 사용량, GPU Utilization, 온도, 전력 소비를 Prometheus 포맷으로 노출합니다.
시스템 메트릭 수집. CPU와 RAM, 디스크 I/O도 같이 봐야 GPU 말고 다른 데서 막히는지 알 수 있습니다.
지표를 모으는 곳. 무한정 쌓이면 디스크가 차서 5GB·7일로 보존 기간을 잘라 뒀습니다.
대시보드. GPU 사용량, 시스템 리소스, 모델 서빙 상태를 시각화합니다. /monitor/ 경로로 서빙.
4-bit로 올린 Qwen-14B는 VRAM 약 8GB
답변 생성이 돌면 로드 직후보다 사용량이 올라감
BGE-M3를 같은 카드에 올린 상태로 16GB 안에서 운영
GPU 서버에서 돌고 있는 페르소나 모델(Qwen-14B)을 밖에서도 부를 수 있게, OpenAI chat completion 포맷에 맞춘 Public API를 만들었습니다.
Bearer 토큰 또는 X-API-Key 헤더로 API Key 검증. 만료·폐기 상태 확인
OpenAI messages 배열에서 사용자 프롬프트 추출. ticketId로 페르소나 테마 매핑
백엔드가 내부망(10.0.x.x:5000)의 AI 서버로 요청을 중계. 120초 타임아웃 + 에러 핸들링
AI 서버 응답을 OpenAI chat.completion 포맷으로 바꿔 반환. 토큰 사용량·비용·레이턴시를 DB에 기록
콘솔에서 발급·폐기. RPM/TPM/RPD 제한 설정. 키별 사용량 독립 추적
요청별 토큰 추정 + 비용 산출. 일별 집계 테이블로 대시보드 조회 지원
GPU 서버는 내부망에서만 접근 가능. 백엔드가 유일한 프록시 경로로 외부 노출 차단
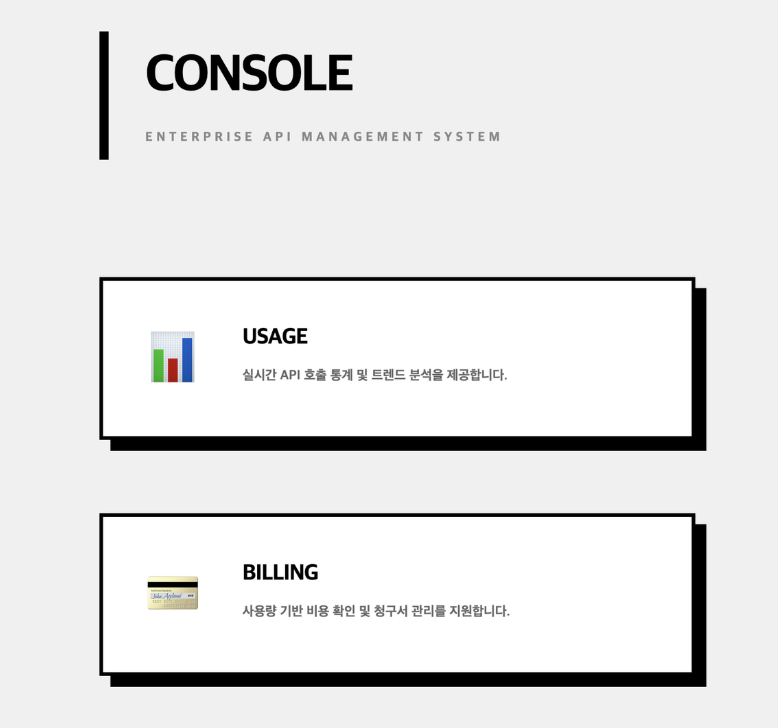
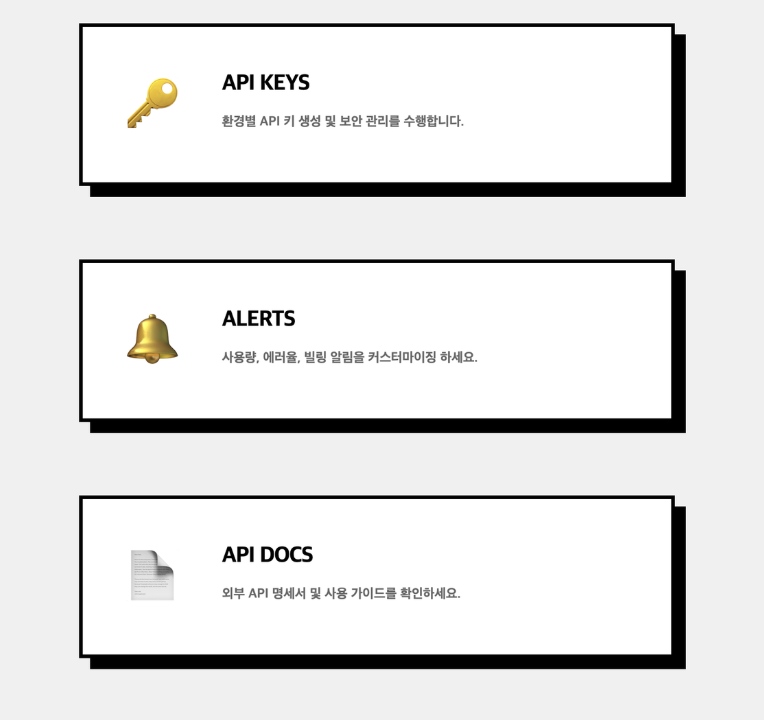
Public API의 사용량·비용·상태를 보고 API Key를 관리하는 웹 콘솔입니다. 프론트엔드와 백엔드를 모두 구현했습니다.
24시간 기준 총 요청 수, 성공률, 평균 레이턴시 표시. 2시간 단위 트래픽 바 차트와 엔드포인트별 호출 빈도 테이블 제공
30일 누적 비용 산출 및 월별 결제 히스토리 조회. 토큰당 단가 기반 비용 모델(Input ₩2,000/M, Output ₩15,000/M) 적용
키 발급·폐기·목록 조회. 키별 상태(active/revoked/expired) 관리 및 프리뷰 마스킹 처리
사용량·에러율·빌링 알림 설정 UI 및 OpenAI 호환 API 명세서 제공
콘솔 전용 토큰으로 로그인. httpOnly 쿠키 기반 세션 관리, 환경별(dev/prod) 쿠키 정책 분리
요청별 로그(cuk_api_usage_logs) + 일별 집계(cuk_api_usage_daily) 2단 구조. 대시보드 조회 시 집계 테이블에서 즉시 응답
기간별 요청 수·성공률·레이턴시 집계 조회. 2시간 단위 바 차트 데이터 반환
월별 비용 집계·결제 히스토리 조회. 토큰 단가 기반 비용 산출
API Key 발급. RPM/TPM/RPD 제한값·만료일 설정
API Key 폐기. 즉시 revoked 전환, 기존 사용 로그 보존
API Key 레코드. 상태(active/revoked/expired), 만료일, RPM·TPM·RPD 제한값 저장. SHA-256 해시로 키 보안 저장
요청별 로그. request_id, 토큰 수, 비용, 레이턴시, IP, User-Agent 기록. 빌링·디버깅 양쪽에 활용
일별 집계. 키·모델별 요청 수, 에러 수, 토큰 합계, 비용 합계를 미리 합쳐 두어 대시보드가 바로 뜸
Project 02
웹소설 작가용 AI 통합 워크스페이스
기획과 집필, AI 보조를 한 프로그램에서 하는 웹소설 작가용 작업 도구.
인프라 설계와 Traefik 리버스 프록시, CI/CD를 맡았습니다.
2026.02 ~ 2026.03
인프라, CI/CD, 리버스 프록시, AI 서빙
Traefik, Docker, GitHub Actions, GHCR, FastAPI, Electron
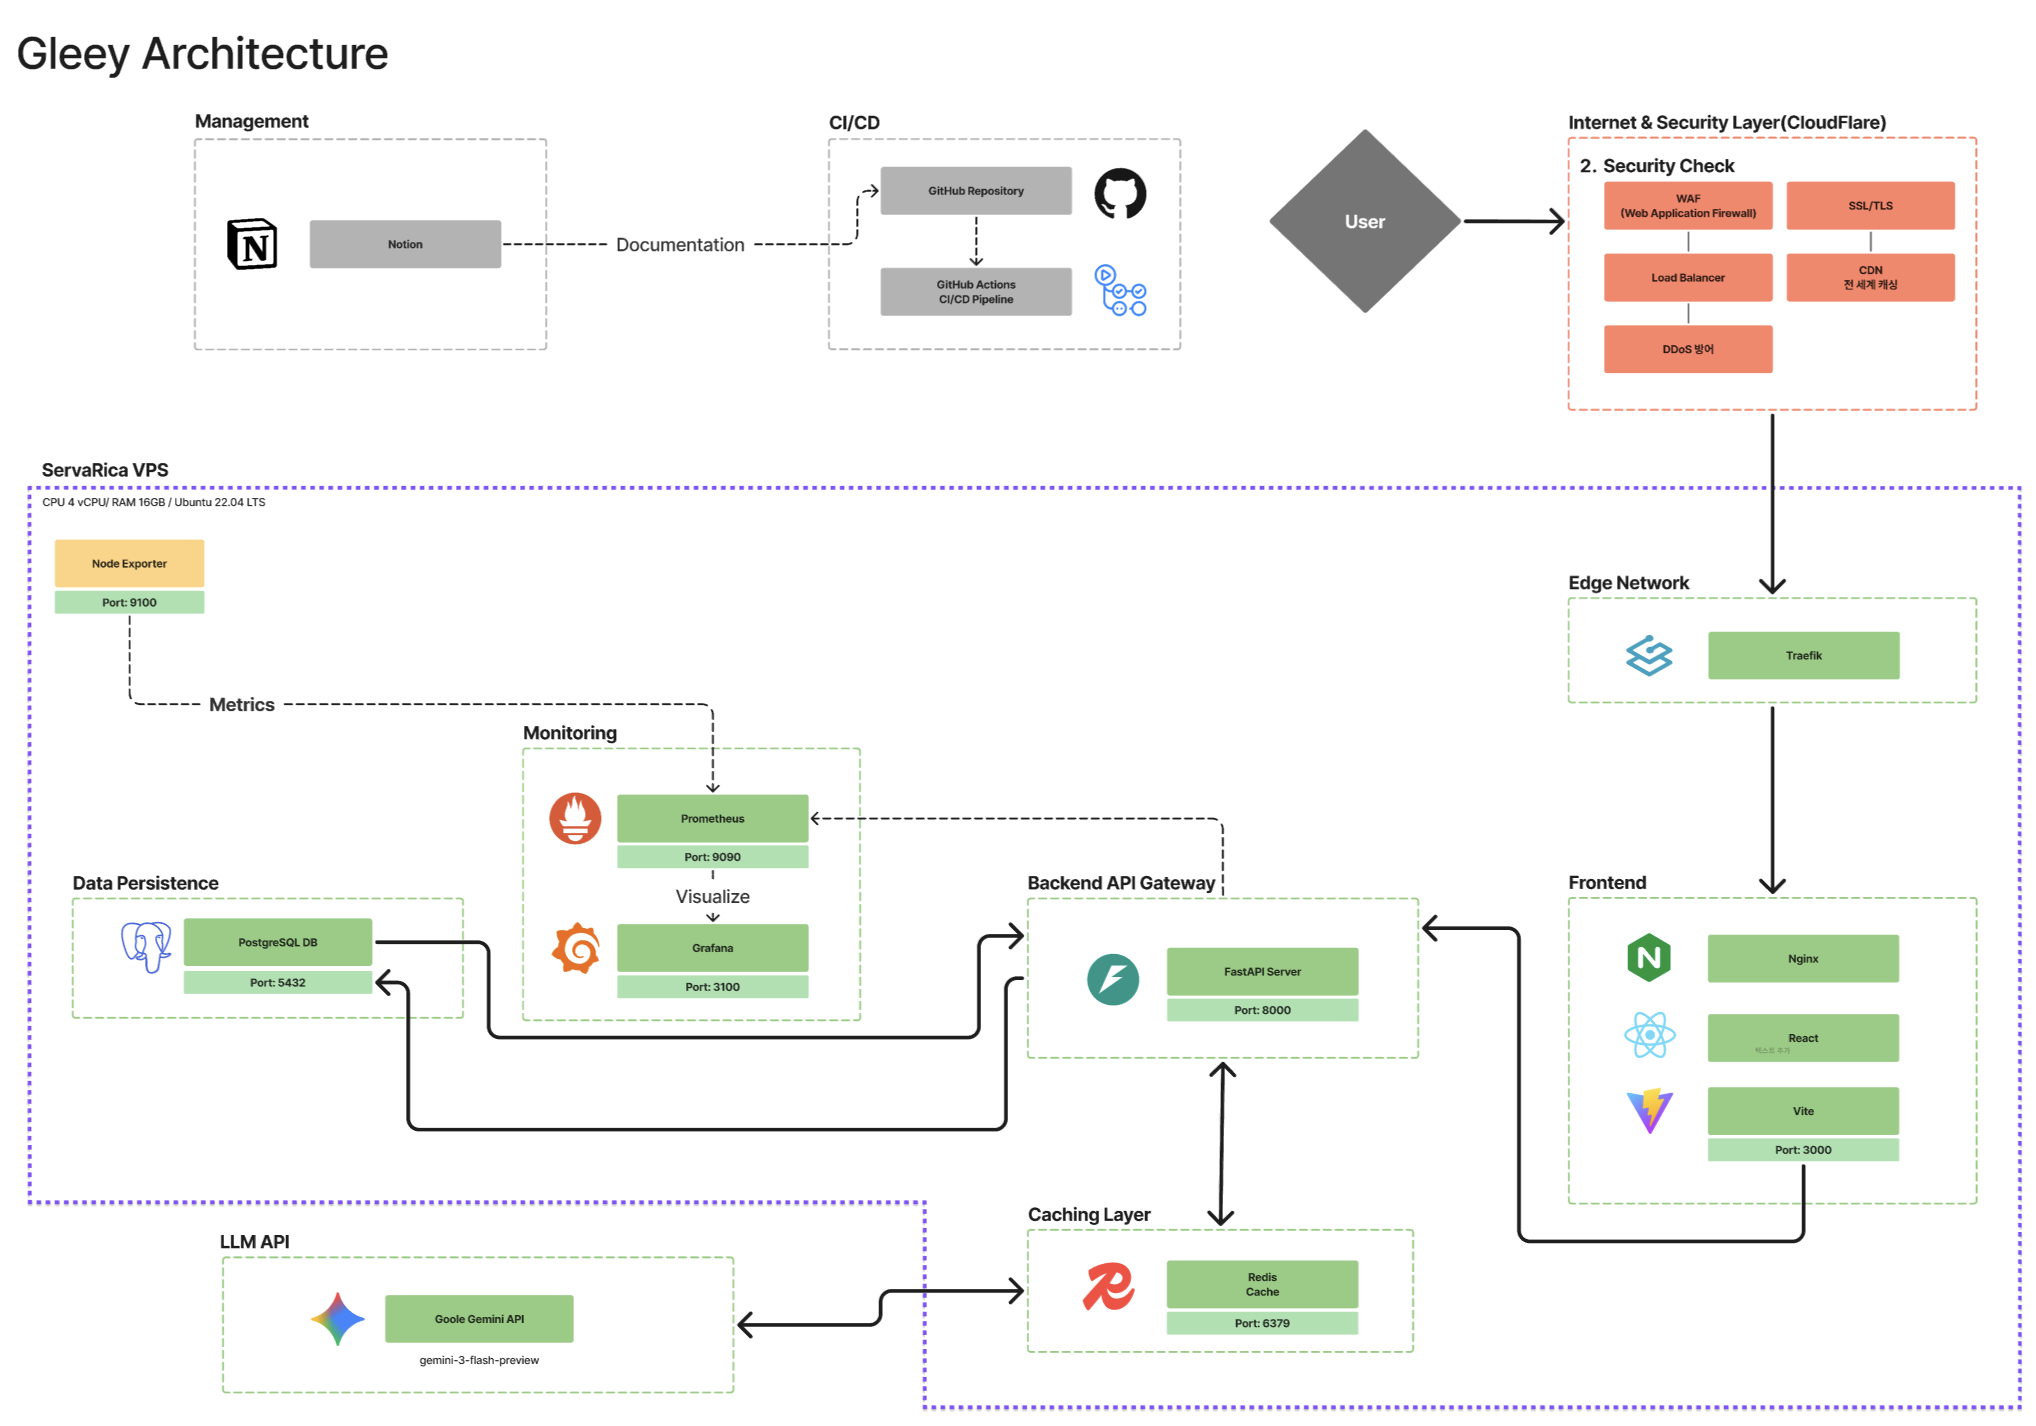
사용자 요청은 Cloudflare(WAF · SSL/TLS · DDoS 방어 · CDN 캐싱)를 거쳐 ServaRica VPS로 들어오고, Traefik(Edge Network)이 받아 각 서비스로 라우팅합니다.
Frontend(Nginx · React · Vite, :3000), Backend API Gateway(FastAPI, :8000), Redis 캐시(:6379)가 VPS 안에서 동작합니다.
데이터는 PostgreSQL(:5432)에 저장하고, 모니터링은 Prometheus · Grafana · Node Exporter로 합니다. AI 기능은 외부 Google Gemini API를 부릅니다.
Gleey는 제품 소개 페이지(랜딩)와 데스크톱 애플리케이션 서비스를 서로 다른 도메인으로 운영해야 했습니다. 서버 한 대에서 프론트엔드, 백엔드, AI 서비스 컨테이너도 같이 돌았습니다.
Traefik 3.6.9를 edge 프록시로 두고, Docker 네트워크를 edge와 gleey-net 둘로 나눴습니다. TLS 인증서는 Cloudflare Origin 인증서를 /etc/traefik/ssl/에 마운트해 씁니다.
Traefik ↔ 외부 트래픽 연결. HTTPS 종단점 역할, 도메인별 라우팅 규칙 적용
서비스끼리만 통신하는 내부망. 밖에서는 접근할 수 없음
Cloudflare Origin 인증서를 파일 마운트. Traefik entrypoint에서 HTTPS 종단 처리
Docker 라벨로 도메인 → 서비스 매핑 선언. 컨테이너 시작만으로 라우팅 자동 반영
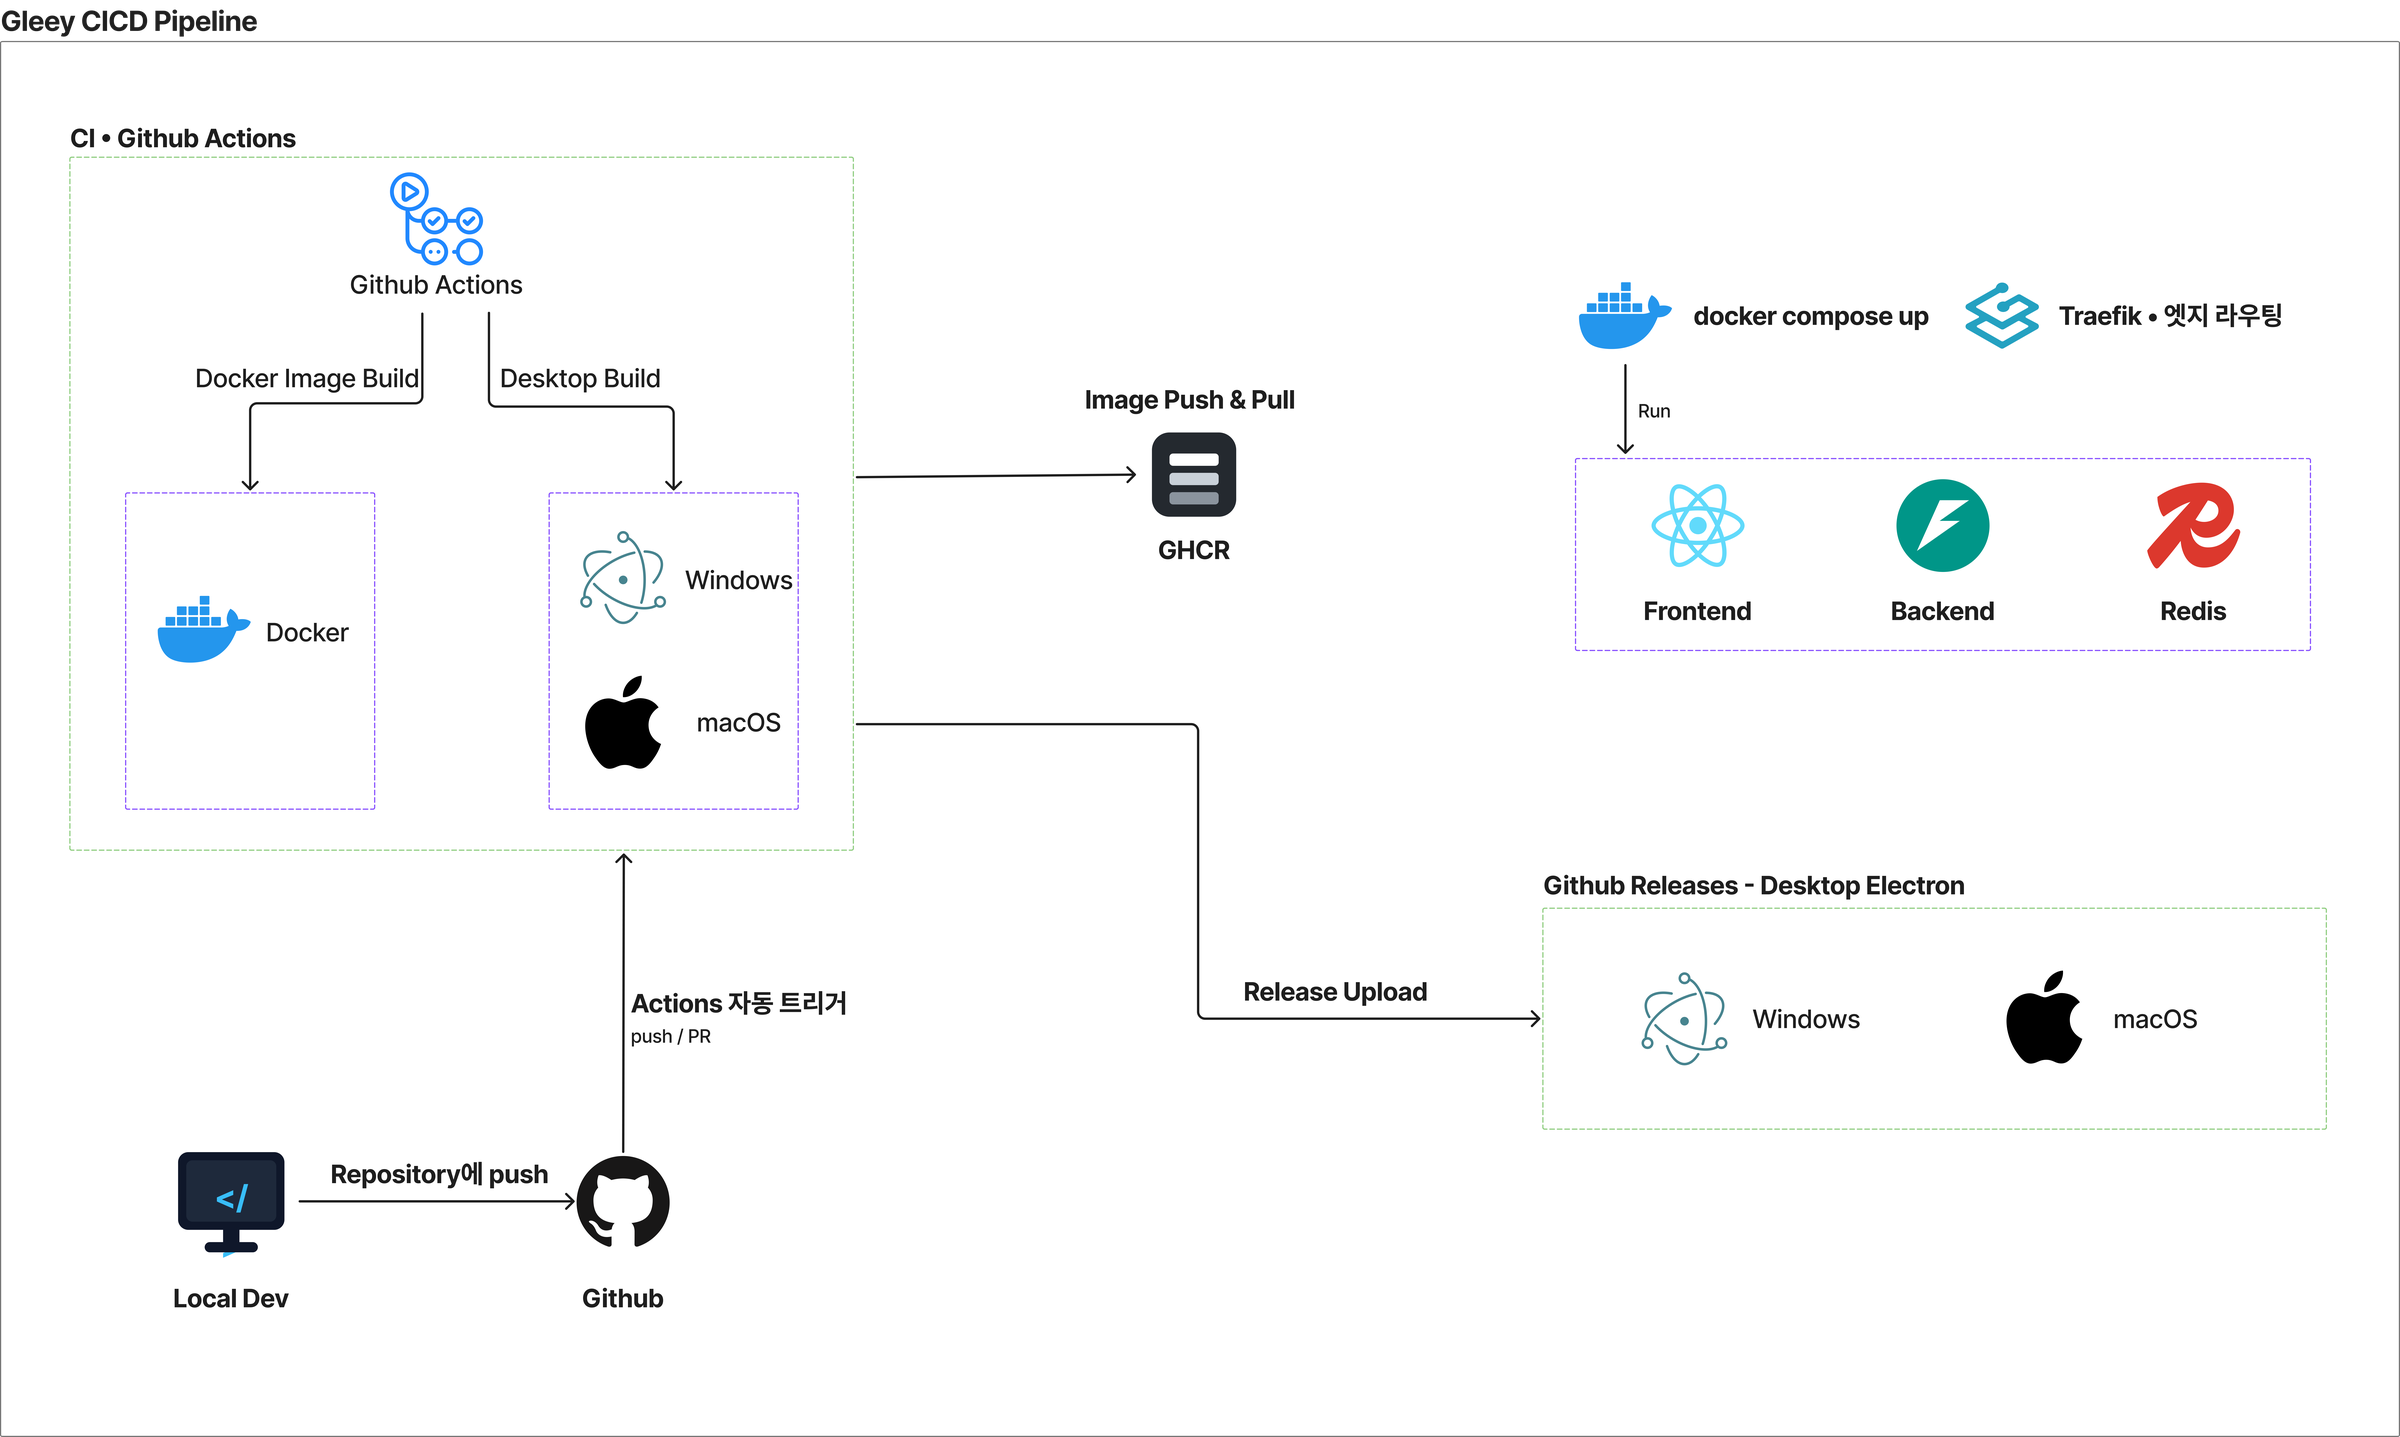
Gleey는 웹, 데스크톱(macOS·Windows), 백엔드 세 갈래라 빌드 환경도 배포하는 곳도 다릅니다. 그래서 워크플로우를 나눴습니다.
macOS에서 Electron 앱을 코드 서명 없이 패키징하면 빌드가 실패했습니다. 그런데 팀 안에서 돌려 볼 버전은 Apple Developer 인증서 없이 만들어야 했습니다.
인증서가 없을 때는 서명 없이 패키징하는 폴백을 넣어 빌드가 되게 했습니다. 그러면서 macOS 창 드래그 영역 문제와, relayout 핸들러가 중복으로 붙던 문제도 같이 고쳤습니다.
dev 브랜치에 push할 때마다 전체 배포 워크플로우가 실행되면서, 불필요한 빌드와 배포가 반복됐습니다.
dev push에 걸려 있던 자동 배포 트리거를 빼고, 정해 둔 feature 브랜치와 workflow_dispatch로만 배포되게 바꿨습니다. concurrency group을 걸어 배포가 겹쳐 돌지 않게 했습니다.
Summary
Prometheus와 Grafana로 GPU를 보면서, 모델을 올린 직후와 답변을 만드는 중을 나눠 16GB 안에 들어오는지 확인했습니다.
저장 공간이 10GB뿐인 앱 서버 대신 100GB가 배정된 GPU 서버에 DB를 두었고, 도메인이 여럿인 Gleey는 라벨로 라우팅되는 Traefik으로 묶었습니다.
Cukee는 워크플로우 6개, Gleey는 5개로 나눠 바뀐 부분만 빌드하고 배포되게 했습니다.
GPU 이미지 호환성, 데스크톱 패키징, 과하게 돌던 배포 트리거를 하나씩 원인을 찾아 고쳤습니다.